Investigacion Owli-AI
Open-Vocabulary Annotation for Pedestrian Scene Understanding under Domain Shift
ECCV 2026 Workshops · ACVR & CDEL (2026) - Contribución de workshop
Justine Buss; Michael Kreutzer; Seyed Eghbal Ghobadi
Technische Hochschule Mittelhessen – University of Applied Sciences, Gießen, Germany
Aviso: esta pagina fue traducida automaticamente y esta pendiente de revision editorial.
Visual
Resumen
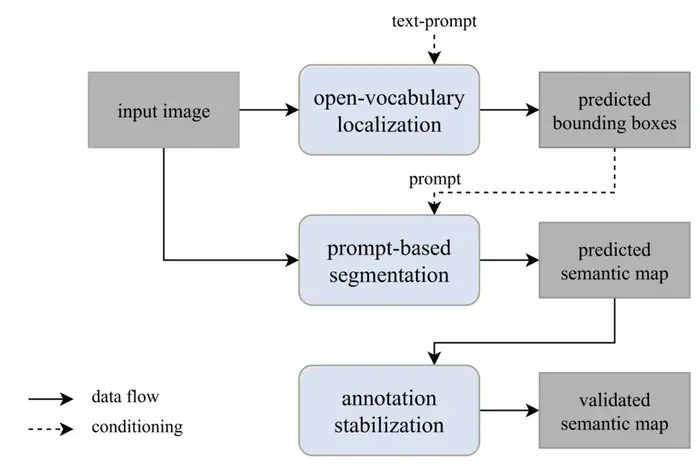
Este trabajo estudia si los modelos de grounding de vocabulario abierto y de segmentación pueden generar anotaciones a nivel de píxel bajo un fuerte cambio de dominio en escenas centradas en peatones. Combina localización de objetos guiada por lenguaje, segmentación mediante prompts y una estrategia de filtrado conservadora. Las pseudoetiquetas resultantes se utilizan para entrenar y evaluar varias arquitecturas de segmentación binaria de aceras y segmentación carretera–acera. Los modelos de mayor capacidad superan el 80 % de mIoU en la segmentación binaria de aceras. Los resultados muestran que estas canalizaciones basadas en modelos fundacionales pueden ser un punto de partida práctico para dominios de visión asistiva con pocos datos, aunque el grounding semántico bajo cambio de dominio sigue siendo una limitación clave.
Palabras clave
- semantic segmentation
- open-vocabulary annotation
- foundation models
- assistive vision
- pedestrian scene domain shift
Descarga
Figuras
2 visuales del paper.
-
Fig. 1: Canalización de anotación basada en modelos fundacionales con localización de vocabulario abierto, segmentación mediante prompts y estabilización posterior. -
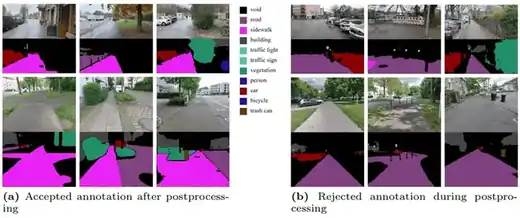
Fig. 2: Comparación de anotaciones aceptadas y rechazadas en el conjunto de datos BGH tras el postprocesado.
Notas adicionales
Contexto de investigación
El trabajo surgió de la tesis de grado de Justine Buss y aborda un requisito central de los sistemas de visión por computador asistiva: cómo crear datos de entrenamiento específicos del dominio con un esfuerzo manual manejable.
La contribución se presentó en ECCV 2026 en Malmö como contribución cruzada a los workshops ACVR – Assistive Computer Vision and Robotics y CDEL – Curated Data for Efficient Learning. Forma parte de la línea de investigación de Owli-AI sobre visión por computador asistiva y movilidad, donde también se encuentra el demostrador experimental Way-Buddy.