Owli-AI Forschung
Open-Vocabulary Annotation for Pedestrian Scene Understanding under Domain Shift
ECCV 2026 Workshops · ACVR & CDEL (2026) - Workshop-Beitrag
Justine Buss; Michael Kreutzer; Seyed Eghbal Ghobadi
Technische Hochschule Mittelhessen – University of Applied Sciences, Gießen, Germany
Visual
Abstract
Die Arbeit untersucht, ob Open-Vocabulary-Grounding- und Segmentierungsmodelle genutzt werden können, um unter starkem Domain Shift pixelgenaue Annotationen für fußgängerzentrierte Szenen zu erzeugen. Dazu werden sprachgesteuerte Objektlokalisierung und promptbasierte Segmentierung mit einer konservativen Filterstrategie kombiniert. Die erzeugten Pseudo-Labels werden anschließend zum Training und zur Evaluation mehrerer Architekturen für binäre Gehwegsegmentierung sowie Straßen-Gehweg-Segmentierung eingesetzt. Modelle mit hoher Kapazität erreichen bei der binären Gehwegsegmentierung mehr als 80 % mIoU. Die Ergebnisse zeigen, dass Foundation-Model-basierte Annotationspipelines eine praktikable Grundlage für Datensätze in datenarmen Assistive-Vision-Domänen sein können, während die semantische Zuordnung unter Domain Shift eine zentrale Grenze bleibt.
Keywords
- semantic segmentation
- open-vocabulary annotation
- foundation models
- assistive vision
- pedestrian scene domain shift
Download
Abbildungen
2 Visuals aus dem Paper.
-
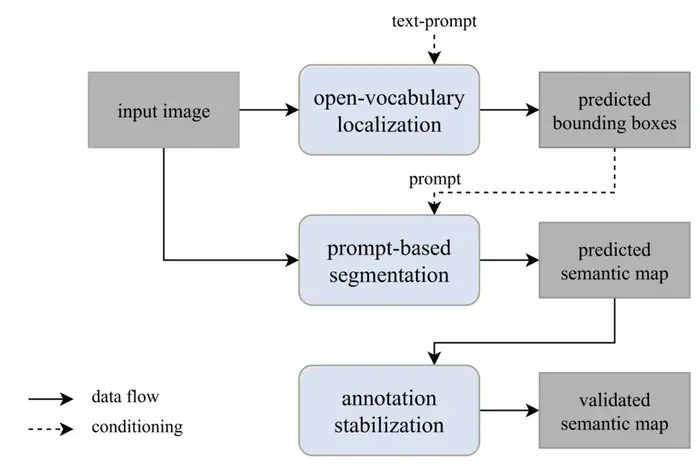
Fig. 1: Foundation-Model-basierte Annotationspipeline mit Open-Vocabulary-Lokalisierung, promptbasierter Segmentierung und nachgelagerter Stabilisierung. -
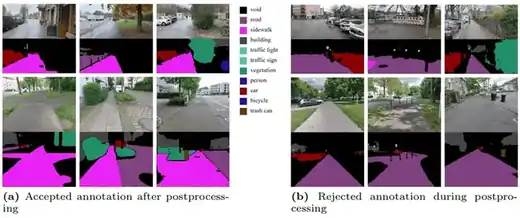
Fig. 2: Vergleich akzeptierter und verworfener Annotationen im BGH-Datensatz nach dem Postprocessing.
Weitere Hinweise
Forschungszusammenhang
Die Arbeit entstand aus der Bachelorarbeit von Justine Buss und untersucht eine zentrale Voraussetzung für assistive Computer-Vision-Systeme: Wie lassen sich domänenspezifische Trainingsdaten mit vertretbarem manuellem Aufwand erzeugen?
Der Beitrag wurde im Rahmen der ECCV 2026 in Malmö als Cross-Contribution zu den Workshops ACVR – Assistive Computer Vision and Robotics und CDEL – Curated Data for Efficient Learning vorgestellt. Thematisch gehört er zum Owli-AI-Forschungsstrang Assistive Computer Vision und Mobilität, in dem auch der experimentelle Way-Buddy-Demonstrator angesiedelt ist.