Owli-AI 研究
Open-Vocabulary Annotation for Pedestrian Scene Understanding under Domain Shift
ECCV 2026 Workshops · ACVR & CDEL (2026) - ワークショップ発表
Justine Buss; Michael Kreutzer; Seyed Eghbal Ghobadi
Technische Hochschule Mittelhessen – University of Applied Sciences, Gießen, Germany
このページは機械翻訳で、現在編集レビュー前です。
ビジュアル
概要
本研究は、歩行者視点のシーンにおける強いドメインシフトの下で、 オープンボキャブラリ・グラウンディングとセグメンテーションモデルを用いて ピクセル単位のアノテーションを生成できるかを検討しています。言語による 物体位置推定、プロンプトベースのセグメンテーション、保守的なフィルタリング を組み合わせ、生成した疑似ラベルを歩道の二値セグメンテーションと 道路・歩道セグメンテーションの学習・評価に利用します。高容量モデルは 歩道の二値セグメンテーションで 80% を超える mIoU を達成しました。 Foundation Model によるアノテーションはデータの少ない支援視覚分野で データセット構築の実用的な出発点となり得る一方、ドメインシフト下での 意味的グラウンディングが主要な制約として残ります。
キーワード
- semantic segmentation
- open-vocabulary annotation
- foundation models
- assistive vision
- pedestrian scene domain shift
ダウンロード
図版
論文内のビジュアル 2 点。
-
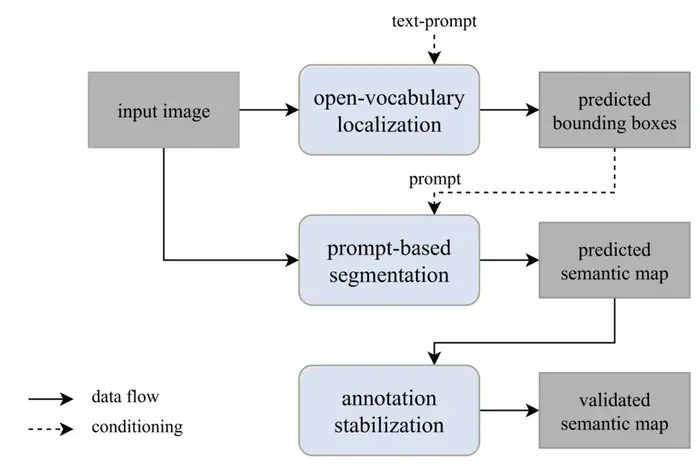
Fig. 1: オープンボキャブラリ位置推定、プロンプトベース・セグメンテーション、後段の安定化処理からなる Foundation Model ベースのアノテーション・パイプライン。 -
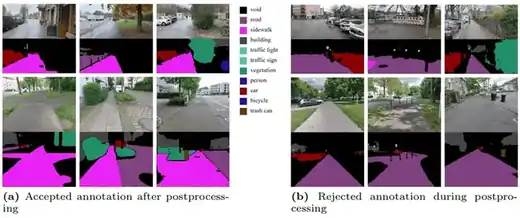
Fig. 2: 後処理後の BGH データセットにおける採用アノテーションと棄却アノテーションの比較。
補足情報
研究背景
本研究は Justine Buss の学士論文から発展したもので、支援コンピュータビジョンに必要なドメイン固有の学習データを、現実的な手作業量でどのように構築できるかを扱います。
この成果は Malmö で開催された ECCV 2026 において、ACVR – Assistive Computer Vision and Robotics と CDEL – Curated Data for Efficient Learning の 2 つのワークショップへのクロスコントリビューションとして発表されました。Owli-AI の支援コンピュータビジョン/モビリティ研究に位置づけられ、実験的な Way-Buddy デモンストレーター も同じ研究領域に含まれます。